証券アナリスト1次の統計は「検定と単回帰」で取る:p値・区間推定・相関係数・t値
証券アナリスト1次の体験記を読むと、単元の名前まで挙げて「難しかった」と書かれることが最も多いのが統計です。受験した30人の体験記のうち、統計を難しかった単元に挙げた人は7人いました。
- 「試験本番で全く手が出せない問題も普通にありました」(ゆみ)
- 「微分積分やらt検定やらゼロベースでした」(怒れるカレー犬)
- 「最後10分くらいかけても全然解けなかった。」(揚塩ころも・2026年春。本人の記憶では、t 分布と、四半期データから「βや標準偏差を算出する問題。」でした)
2026年4月から10月にかけて X で受験者・学習者の声を集めても、単元を挙げてつまずきを書いた13人のうち4人が統計を挙げ、テーマ別で最多でした。
この記事から始まる「証券アナリスト1次 頻出テーマ」は、3科目から、よく出て受験者がつまずきやすいテーマを1回に1つずつ取り上げる全10回の連載です。以前の連載では、体験記の読み方や勉強時間など「全体の戦い方」を扱いました。今回の連載では、計算の手順まで掘り下げ、読み終えたときにそのテーマの問題を自力で解ける状態をめざします。
書いているのは、資格の問題集アプリ「ナレッジバンドル」を作っているチームです。証券アナリスト1次の3科目・計1,500問を作るときに体験記を読むと、単元の名前を挙げて難しかったと書かれていたのは統計がいちばん多い分野でした。ただ、1次の統計の計算は、手順さえ決まっていれば四則演算と √ で終わるものがほとんどです。私たちが全問に「正解の理由」と「各選択肢の正誤」の解説を付けているのは、答えに至る手順を1問ごとに確かめられるようにするためです。
▶ アプリ「ナレッジバンドル」はこちら
第1回の今回は、統計のうち 仮説検定と単回帰 を、3つの例題で手順どおりに解いていきます。
学習ポイントでの位置:「計算できる」「解釈できる」が並ぶ
統計は、科目Ⅲの「数量分析と確率・統計」に入ります。協会のスタディ・ガイドは、この分野について「「使える」、「計算できる」ことを重視しています」と書いています(協会 スタディ・ガイド)。
2026年度の学習ポイント(2027年の試験の範囲)では、この記事で扱う項目に次の到達目標が付いています(協会 学習ポイント)。
- 「p値について理解し仮説検定に応用できる。」
- 「母平均の区間推定について理解し、標本分布の統計量から標準正規分布やt分布を用いて母平均の区間推定ができる。」
- 「標本の相関係数を計算できる。」
- 「単回帰分析について理解し、回帰結果を解釈できる。」
検定の手順、片側と両側、第1種・第2種の過誤と検定力、単回帰の検定は「理解する」の項目です。一方、重回帰はすべて2次レベル に回っているので、1次では説明変数が1つの単回帰までを固めれば足ります。
型1:仮説検定は4つの手順で解く
検定の問題は、数値が変わっても手順は毎回同じです。
- 帰無仮説(H0)と対立仮説(H1)を立てる。片側か両側かも、データを見る前にここで決める
- 有意水準 α を決め、検定統計量の分布と棄却域を決める
- 標本から検定統計量を計算する
- 統計量が棄却域に入れば H0 を棄却する(p値が α 以下なら棄却、と言っても同じ)
例題1:平均は4%より大きいか
ある戦略の月次超過リターンを16か月分集めたところ、標本平均は5.2%、標本標準偏差は2.0%だった。平均が4%より大きいと、有意水準5%で言えるか。
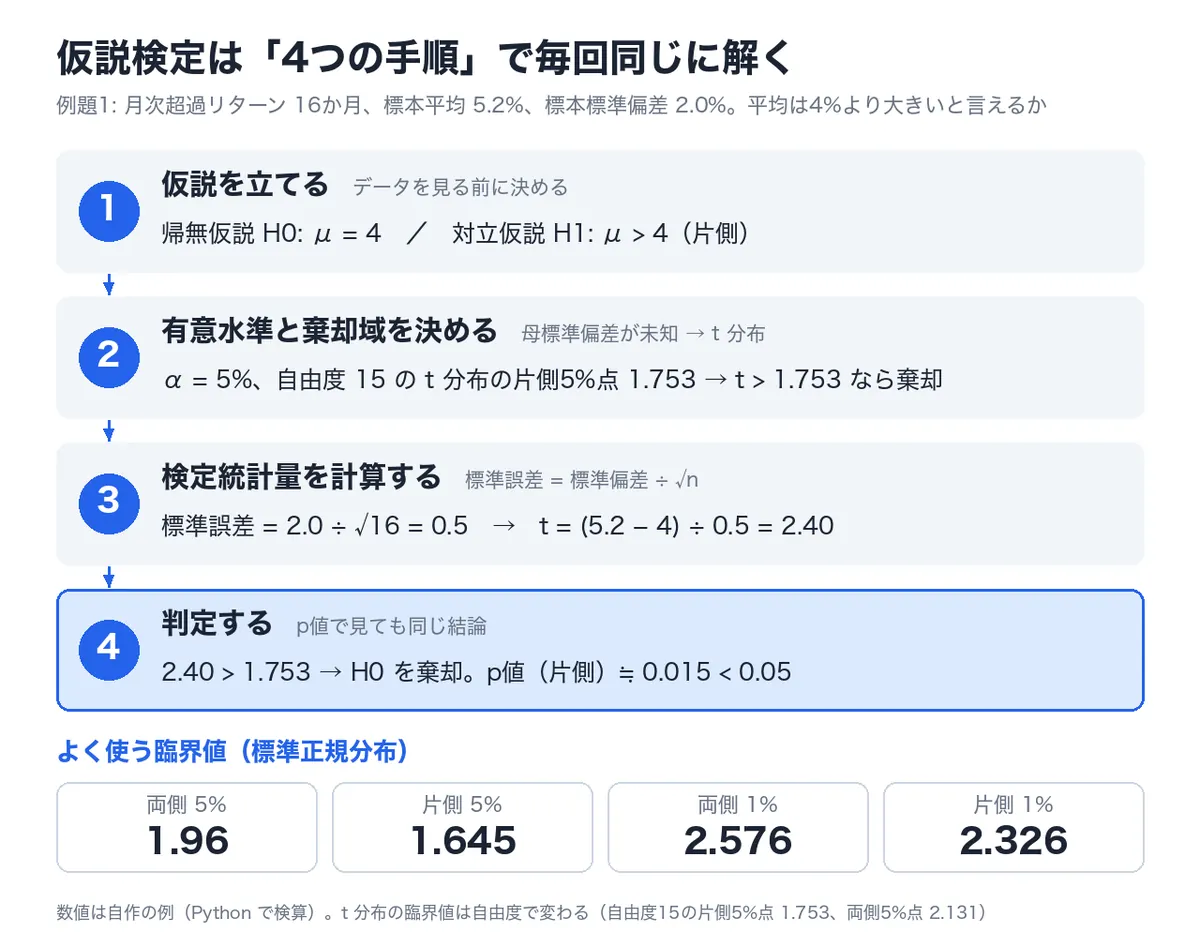
- H0: μ = 4、H1: μ > 4。「大きいか」を問うので片側検定です
- 母集団の標準偏差は分からず、標本の値を使うので t 分布(自由度 n − 1 = 15)。片側5%点は1.753
- 標準誤差 = 2.0 ÷ √16 = 0.5。t = (5.2 − 4) ÷ 0.5 = 2.40
- 2.40 > 1.753 なので H0 を棄却し、「平均は4%より大きい」と判断します。p値は片側で約0.015です
p値は「帰無仮説が正しい確率」ではない
p値は、帰無仮説のもとで、観測された値と同じかそれ以上に極端な値が出る確率です。アメリカ統計協会(ASA)の声明(日本計量生物学会による日本語訳)は、よくある読み違いをこう戒めています。
「P値は、調べている仮説が正しい確率や、データが偶然のみでえられた確率を測るものではない。」
同じ声明は、p値が効果の大きさを表すものでもないと書いています。計算では「5%で棄却できるか」を機械的に判定すれば足りますが、文章の正誤を選ぶ問題に備えて、この区別も押さえておきましょう。
片側と両側で結論が変わる
検定統計量 z = 1.80 が出たとします。片側なら p ≒ 0.036 で5%で棄却、両側なら p ≒ 0.072 で棄却できません。対称な分布では、両側の p値は片側のちょうど2倍です。データを見てから都合のよいほうに切り替えるのは誤りで、だから手順1で決めておきます。
第1種の過誤・第2種の過誤・検定力
- 第1種の過誤:H0 が正しいのに棄却してしまう。起きる確率が有意水準 α
- 第2種の過誤:H0 が誤っているのに棄却しない。確率を β と書く
- 検定力(検出力):誤った H0 を正しく棄却できる確率で、1 − β
母標準偏差が2と分かっている母集団から25個の標本を取り、H0: μ = 0 を片側5%で検定する場面で、真の平均が1.0だったとします。標準誤差は 2 ÷ √25 = 0.4 なので、棄却点は標本平均で 1.645 × 0.4 = 0.658、検定力は約0.80(β は約0.20)です。片側1%に厳しくすると検定力は約0.57に下がり、標本を100に増やすと約0.9996に上がります。α を下げると β が上がり、両方を下げるには標本を増やす、という関係です。
区間推定は「1.96 か t か」
例題1のデータで母平均の95%信頼区間を作ると、母標準偏差を2.0と分かっているとみなせば 5.2 ± 1.96 × 0.5 = 4.22〜6.18。標本標準偏差を使うなら t 分布(自由度15)の両側5%点2.131を使って 4.13〜6.27 で、少し広くなります。99%なら1.96の代わりに2.576を使います。
95%信頼区間は「母平均がこの区間に95%の確率で入る」という意味ではありません。同じやり方で何度も区間を作ると、そのうち95%が母平均を含む、という意味です(九州大学 数理・データサイエンス教育研究センター)。
型2:相関係数と単回帰は「3つの和」から
相関係数も回帰の傾きも、平均との差(偏差)から作る3つの和で計算できます。
- Sxx:x の偏差の2乗の和
- Syy:y の偏差の2乗の和
- Sxy:x の偏差 × y の偏差の和
相関係数 r = Sxy ÷ √(Sxx × Syy)、つまり共分散を x と y の標準偏差の積で割ったものです(総務省統計局 なるほど統計学園)。単回帰 y = a + bx の傾きは b = Sxy ÷ Sxx(x と y の共分散 ÷ x の分散)、切片は a = y の平均 − b × x の平均です。回帰直線は必ず平均の点を通ります。
例題2:6か月分のデータで r と回帰直線を出す
市場の超過リターン x が 2, −1, 3, 0, 4, −2、ある銘柄の超過リターン y が 3, −1, 2, 1, 5, −2(単位は%)のとき、相関係数と、y を x に回帰した直線を求める。
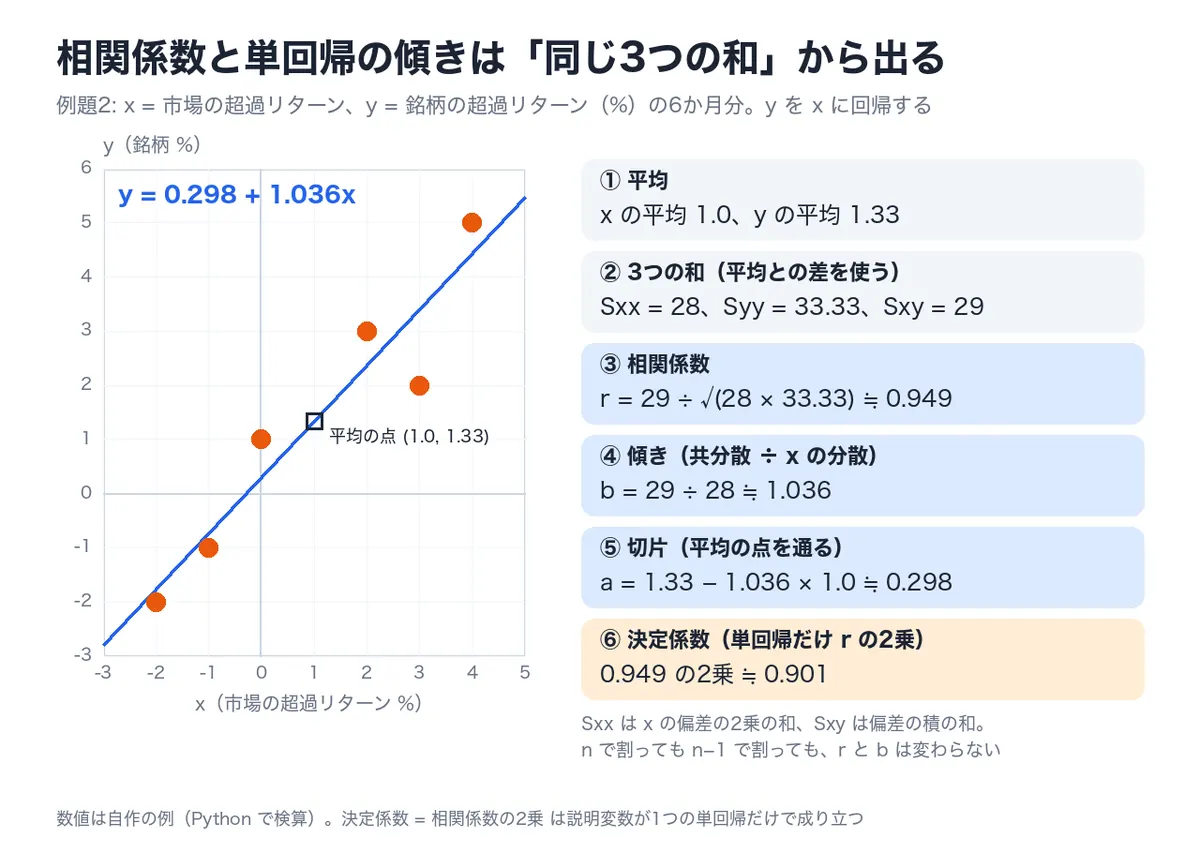
- 平均:x は 6 ÷ 6 = 1.0、y は 8 ÷ 6 ≒ 1.33
- 3つの和:Sxx = 28、Syy ≒ 33.33、Sxy = 29
- 相関係数:r = 29 ÷ √(28 × 33.33) ≒ 0.949
- 傾き:b = 29 ÷ 28 ≒ 1.036。切片:a = 1.33 − 1.036 × 1.0 ≒ 0.298
- 決定係数:0.949の2乗 ≒ 0.901。y のばらつきの約90%を x で説明できています(学習ポイントに「決定係数」という語は無く、単回帰直線の「説明力」として出てきます)
共分散や分散を n で割っても n − 1 で割っても、r と b は変わりません。分子と分母で同じ数が消えるからです。手計算では割らずに和のまま進めると、計算が1段減ります。
例題3:回帰の出力表を読む
銘柄の超過リターンを市場の超過リターンに回帰したところ、30か月分のデータで、x の係数(ベータ)の推定値1.2、標準誤差0.4という出力が出た。
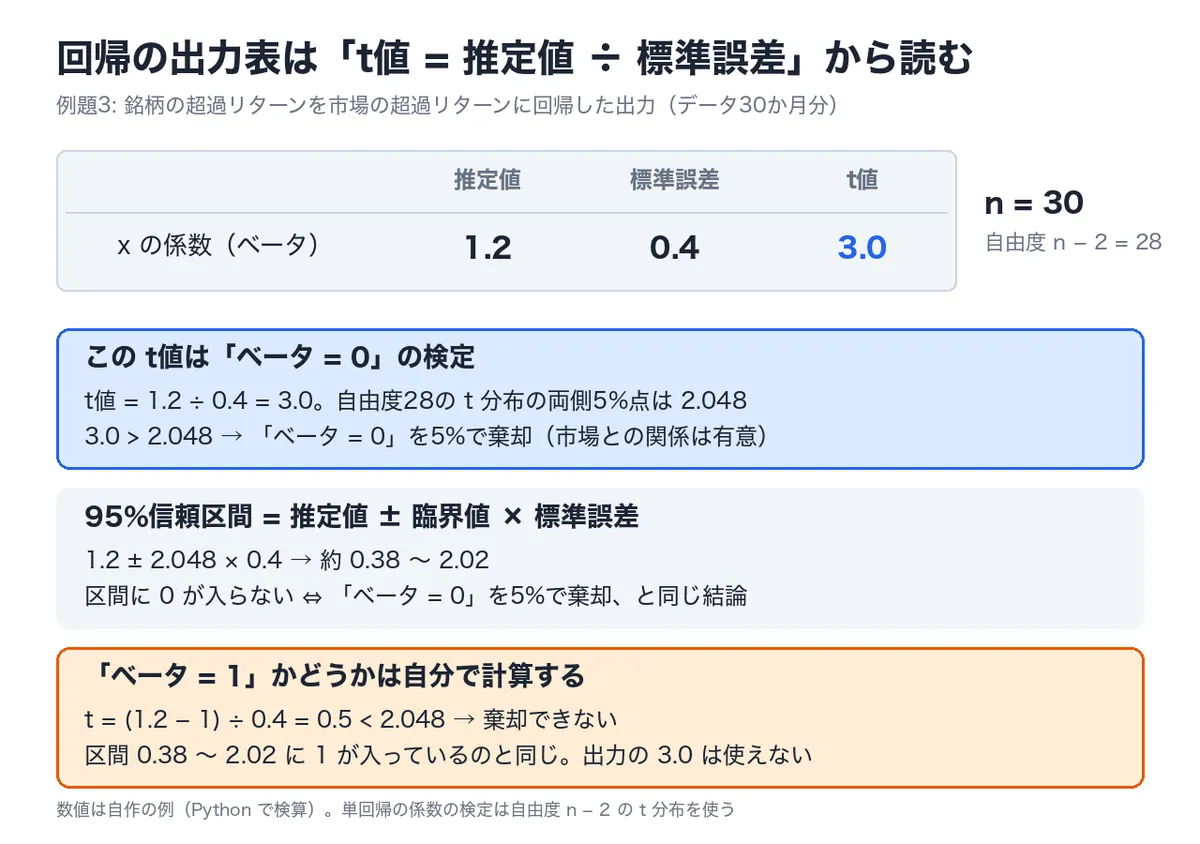
- t値 = 推定値 ÷ 標準誤差 = 1.2 ÷ 0.4 = 3.0。単回帰の係数の検定は自由度 n − 2 = 28 の t 分布で、両側5%点は2.048。3.0 > 2.048 なので「ベータ = 0」を棄却します
- 95%信頼区間:1.2 ± 2.048 × 0.4 で、約0.38〜2.02
- 「ベータは1と違うか」を問われたら、出力の3.0は使えません。t = (1.2 − 1) ÷ 0.4 = 0.5 で、棄却できません。区間に1が入っていることと同じ結論です
出力表の t値は、いつも「係数 = 0」を帰無仮説にした値です。
取り違えやすいペア
- p値と「帰無仮説が正しい確率」:別物。p値が小さいことは、効果が大きいことも意味しない
- 「棄却できない」と「帰無仮説が正しい」:棄却できないのは、否定する根拠が足りないというだけ
- 1.96・1.645・2.576:両側5%、片側5%、両側1%。片側1%は2.326
- z と t:母標準偏差が未知で標本の値を使うなら t(自由度 n − 1)。単回帰の係数は t(自由度 n − 2)
- 第1種と第2種:正しい H0 を捨てるのが第1種(α)、誤った H0 を残すのが第2種(β)。検定力は 1 − β
- 傾きと相関の強さ:傾きは単位で変わる。当てはまりのよさは r や決定係数で見る
- 決定係数 = r の2乗:成り立つのは単回帰だけ。重回帰の決定係数は2次の範囲です
- 相関が0なら無関係:直線的な関係が無いだけで、ほかの形の関係はありうる。偶然の高い相関(見せかけの相関)にも注意
確認問題
この記事のために作った問題で、本番の問題の再現ではありません。4択で、答えと解説は3問のあとにまとめています。
問1
ある指標の25か月分のデータで、標本平均1.0、標本標準偏差2.0だった。H0: μ = 0、H1: μ ≠ 0 を有意水準5%で検定する。t値と結論の組合せとして正しいものはどれか(自由度24の t 分布の両側5%点は2.064、両側1%点は2.797)。
- t = 0.5、棄却できない
- t = 2.5、棄却する
- t = 2.5、棄却できない
- t = 12.5、棄却する
問2
x が 1, 2, 3, 4, 5、y が 2, 4, 5, 4, 5 のとき、相関係数 r と、y を x に回帰した直線の傾き b の組合せとして正しいものはどれか。
- r ≒ 0.77、b = 0.6
- r = 0.6、b ≒ 0.77
- r ≒ 0.77、b = 1.0
- r = 0.6、b = 0.6
問3
検定と回帰の説明として、最も適切なものはどれか。
- p値が0.03なら、帰無仮説が正しい確率は3%である
- 有意水準を5%から1%に下げると、第2種の過誤の確率は小さくなる
- 40か月分の単回帰で係数1.3・標準誤差0.5なら、出力の t値2.6から「係数は1と異なる」と5%水準で言える
- ほかの条件が同じなら、標本を大きくすると検定力は高くなる
答えと解説
- 問1: 2。標準誤差 = 2.0 ÷ √25 = 0.4、t = 1.0 ÷ 0.4 = 2.5 > 2.064 なので棄却します。1 は √n で割り忘れて標準誤差を2.0とした値、4 は √n ではなく n で割った値です。3 は5%の検定で両側1%点の2.797と比べた誤りです
- 問2: 1。平均は x が3、y が4。Sxx = 10、Syy = 6、Sxy = 6 なので、r = 6 ÷ √60 ≒ 0.775、b = 6 ÷ 10 = 0.6。3 の1.0は Sxy ÷ Syy で、x を y に回帰したときの傾きです。4 の0.6は、決定係数(0.775の2乗 = 0.6)を r と取り違えています
- 問3: 4。1 は ASA 声明が戒める読み違いです。2 は逆で、α を下げると β は大きくなります。3 は出力の t値が「係数 = 0」の検定である点を見落としています。(1.3 − 1) ÷ 0.5 = 0.6 で、自由度38の両側5%点(約2.02)を下回るので、「1と異なる」とは言えません
まとめ
- 検定は 仮説 → 有意水準と棄却域 → 統計量 → 判定 の4手順。片側か両側かは最初に決める
- 標準誤差は 標準偏差 ÷ √n。母標準偏差が未知なら t 分布(自由度 n − 1)
- p値は帰無仮説が正しい確率ではない。α を下げると β が上がり、標本を増やすと両方を下げられる
- 相関係数と傾きは Sxx・Syy・Sxy から。r = Sxy ÷ √(Sxx × Syy)、b = Sxy ÷ Sxx
- 単回帰では決定係数 = r の2乗。出力の t値は「係数 = 0」の検定で、自由度は n − 2
統計は、式を覚えるより同じ手順を何度か手で回すほうが身につきます。私たちのアプリでも「間違えた問題だけ」に絞って解き直せるので、つまずいた計算だけを繰り返せます。2026年秋の試験の合否は11月中旬ごろの発表予定で、これから始める人は2026年度の学習ポイントが2027年の試験の範囲になります。
連載の第2回は「お金の時間価値」です。実効利子率、スポットレートとフォワードレートの換算、金額加重と時間加重の収益率を、今回と同じく計算の手順で整理します。
証券アナリスト1次の3科目・計1,500問をアプリで解くなら「ナレッジバンドル」
資格対策アプリ「ナレッジバンドル」には、証券アナリスト1次のオリジナル問題3科目・計1,500問がすべて入っています。スキマ時間に1問ずつ解いて、間違えた問題だけを繰り返せます。
- 全問に解説つき。解説の用語はタップで証券アナリスト1次専用の用語辞書が開き、関連用語もたどれる
- 解説を読んでも引っかかったら、その問題をそのままAIに質問。Google検索もワンタップ
- 忘却曲線で復習を自動出題。「間違えた問題だけ」「未回答だけ」「ランダム」など出題の絞り込みも自由
- 本番形式テストで、いまの合格率と弱点カテゴリをグラフで確認
- 広告なし。全教材は無料体験できます
証券アナリスト1次のほか、100以上の資格・検定(レビュー中含む)が1つのアプリで使い放題です。アプリ内の教材追加画面で「証券アナリスト1次」と検索してください。
※この記事は2026年10月15日時点の公開情報をもとにしています。試験制度や学習ポイントは年度ごとに見直されることがあるので、受験前に必ず日本証券アナリスト協会の公式サイトで確認してください。体験記の引用は各記事の原文から行い、リンク先に出典を明記しています。計算例と確認問題はこの記事のために作ったもので、本番の問題の再現ではありません。